Opus 5.5 对 GPT-6 Sol,谁更强?
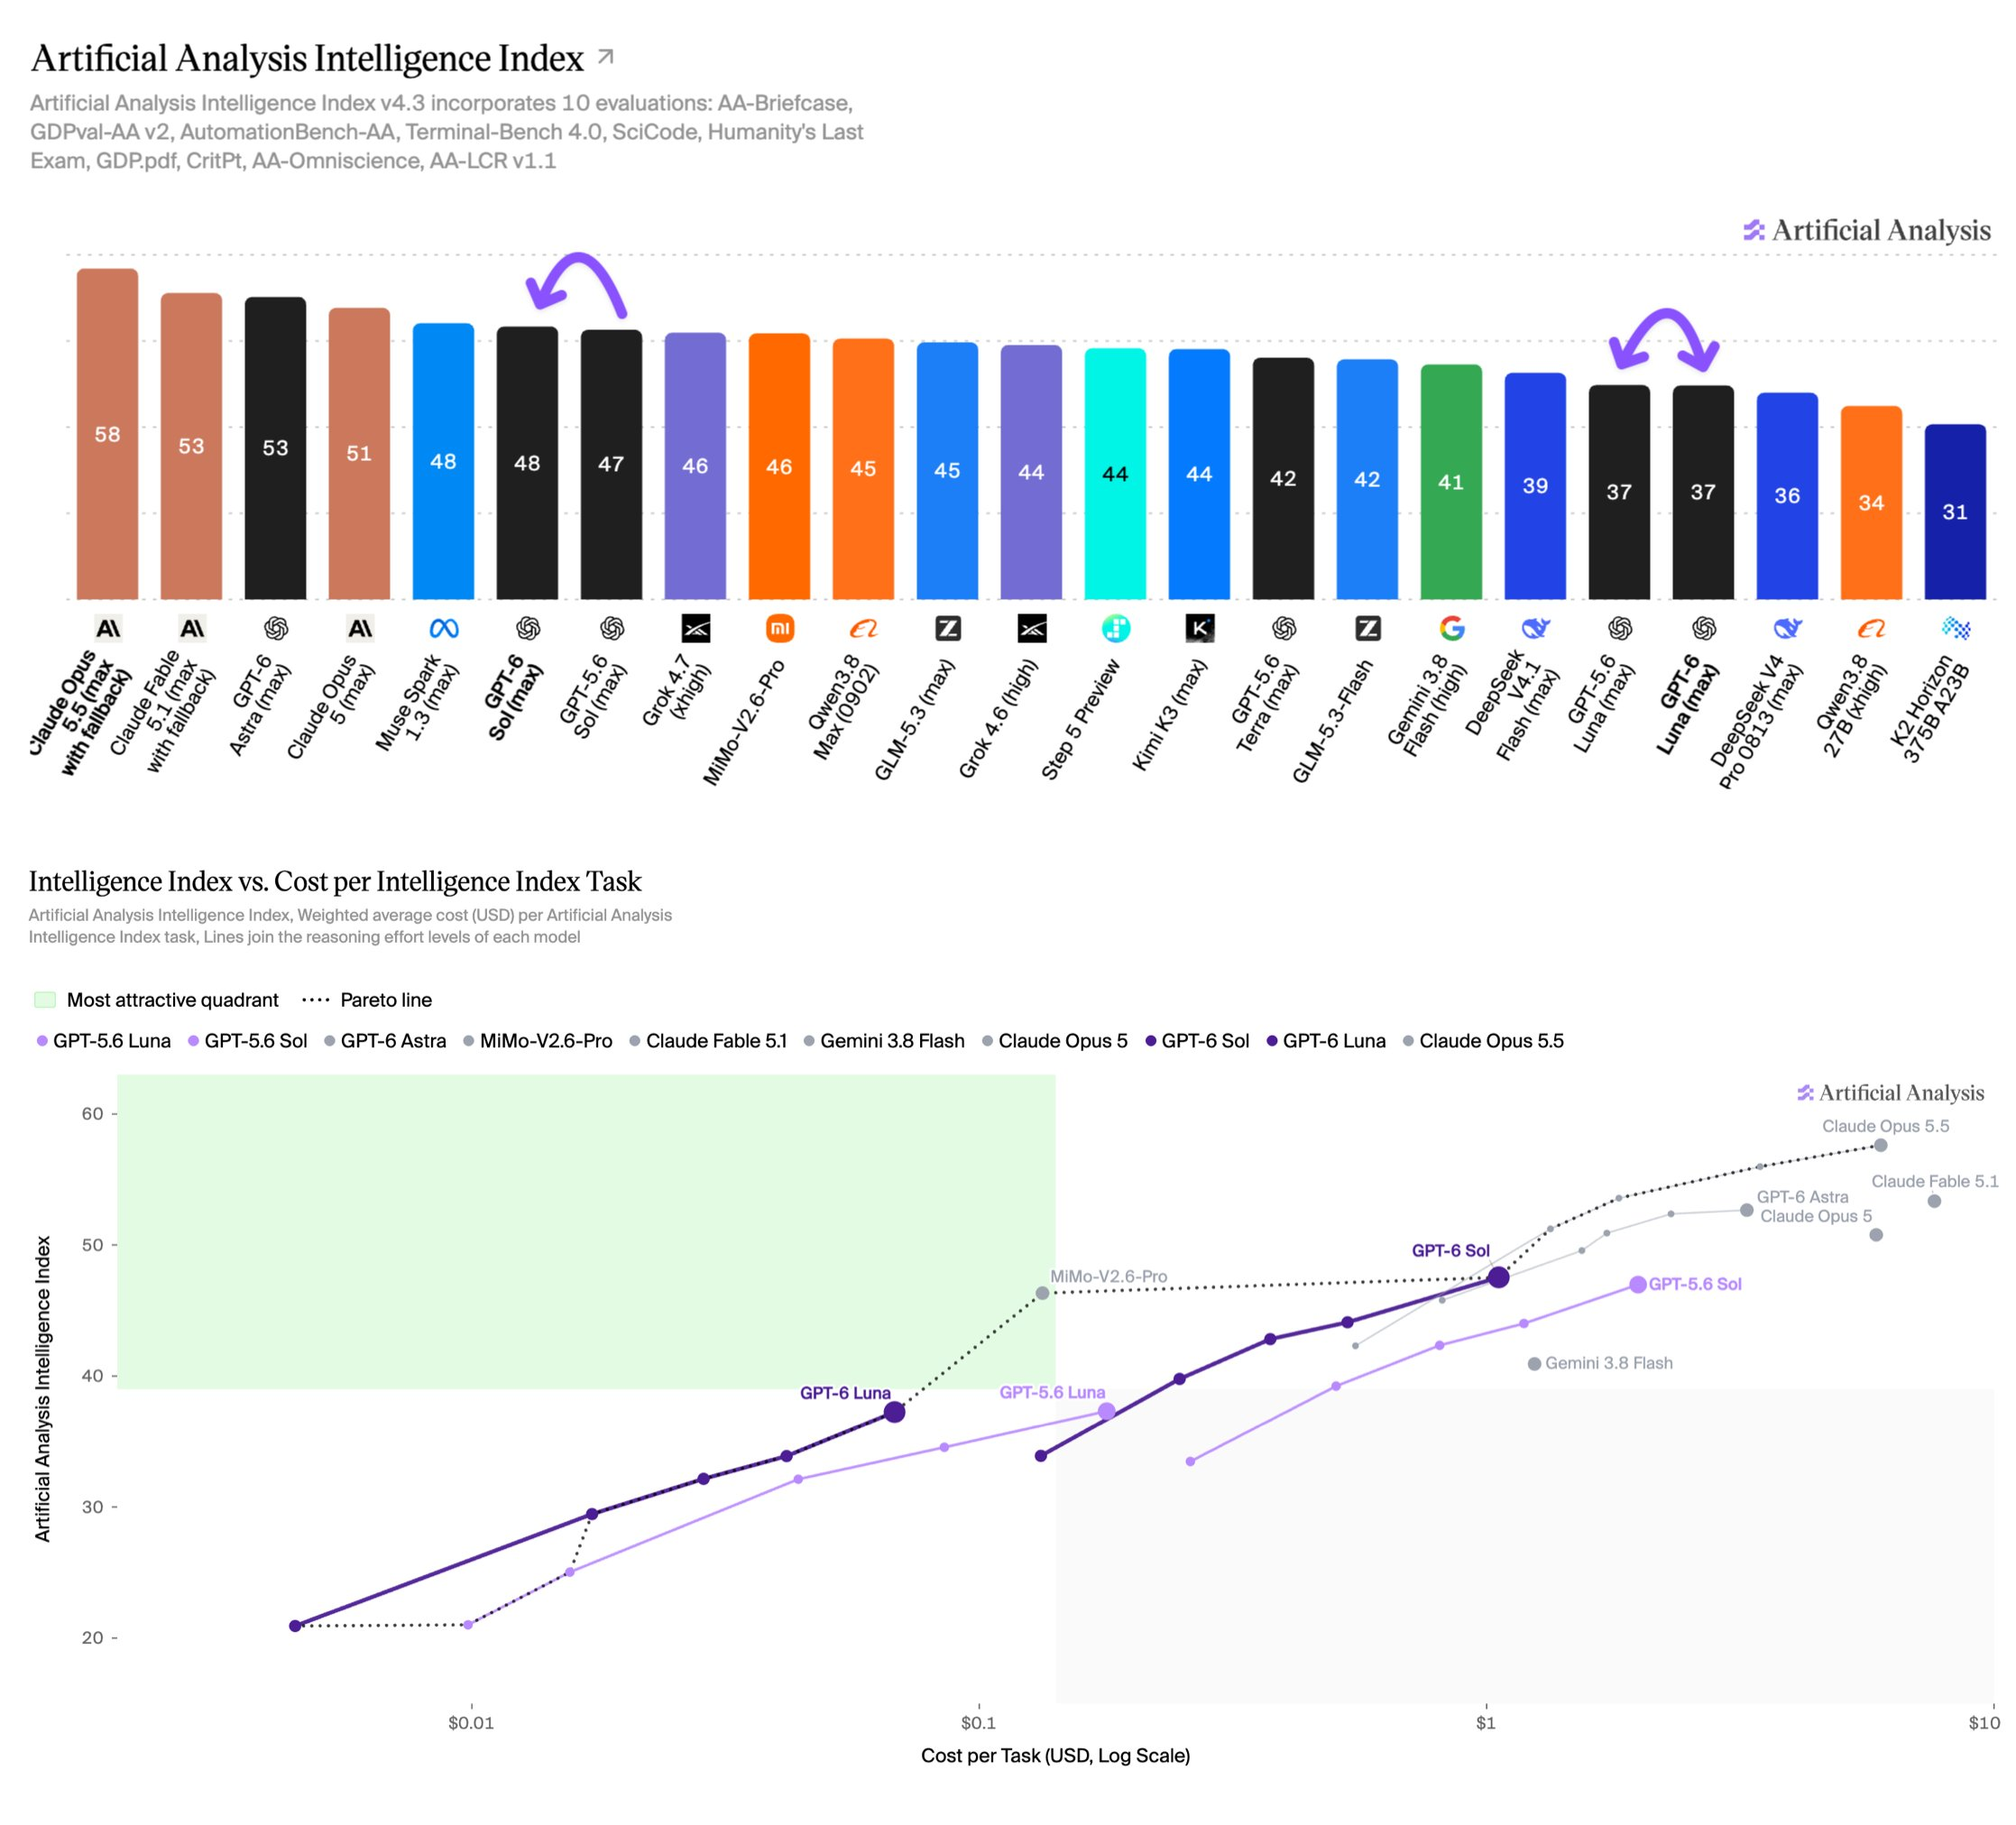
美国时间 9 月 22 日Anthropic 发布了 Claude Opus 5.5。大约 90 分钟后OpenAI 发布了 GPT-6 Sol 和 GPT-6 Luna。两家打的是同一张牌能力不降价格往下砍。Opus 5.5 比上一代 Opus 5 便宜约 40%Sol 和 Luna 的 API 价格直接比上一代砍了一半。那么这两个模型放在一起到底谁更强先说结论Opus 5.5 能力更强Sol 单价更低但Sol 一定更省钱并不成立。1、定位一个往上够旗舰一个往下铺主力Anthropic 对 Opus 5.5 的说法是大多数工作能达到自家旗舰 Claude Fable 5.1 的水平运行成本比 Opus 5 低约 40%输出速度快 30% 以上。它是 Claude 5.5 系列的第一个模型Sonnet 5.5 和 Haiku 5.5 会在接下来几周跟上。OpenAI 这边本月初发布的 GPT-6 Astra 才是旗舰。Sol 主打复杂编程和 Agent 工作流Luna 负责抽取、摘要、快速问答这类大批量任务。原来夹在中间的 Terra 已经下线。两家的产品线放在一起看定价档OpenAIAnthropic$10 / $50GPT-6 AstraClaude Fable 5.1另有限量开放的 Mythos 5.1$4 / $20无Claude Opus 5.5$2 / $10GPT-6 SolClaude Sonnet 5$0.10 / $0.50GPT-6 Luna无Haiku 5.5 尚未发布价格单位是美元每百万 token斜杠前是输入价后面是输出价。按命名对位媒体普遍把 Sol 看作 Opus 的对手、Luna 看作 Haiku 的对手。但按价格对位Sol 真正的同价竞品是 Claude Sonnet 5两者都是 2 美元和 10 美元。所以这场对比从一开始就不完全对等Opus 5.5 的单价是 Sol 的两倍它要证明的是多花的钱值不值。2、价格单价差两倍每任务成本要看档位先看账面价格。模型输入输出缓存读取Claude Opus 5.5$4$20$0.20GPT-6 Sol$2$10$0.20GPT-6 Luna$0.10$0.50$0.01Sol 的输入和输出单价正好是 Opus 5.5 的一半。缓存读取两家都是 0.20 美元打平。长时间跑的 Agent 会反复读同一段上下文缓存读取往往占了账单的大头。Anthropic 这次把缓存读取从 0.50 美元砍到 0.20 美元降了 60%比砍单价更实在。OpenAI 的价格还有两处细节Batch 和 Flex 模式在此基础上再打五折。单次请求输入超过 27.2 万 token整次请求按长上下文计价输入和缓存价翻倍输出涨 50%。Sol 变成 4 美元和 15 美元Luna 变成 0.20 美元和 0.75 美元。两个模型都号称 105 万 token 上下文但不能拿这个长度直接乘以 2 美元。单价只是一半。另一半是完成一个任务要用掉多少 token。第三方评测机构 Artificial Analysis 在同一套智能指数任务上测了两家的模型。开到最高档max时Opus 5.5 每个任务平均输出约 11.9 万 tokenSol 只有约 3.1 万。![这样算下来max 档的 Opus 5.5 每任务约 6 美元Sol 是 1.06 美元Luna 只要 0.07 美元。单价差两倍每任务成本差到五倍多。但这个差距只在 max 档成立。Opus 5.5 默认用的是中档medium。Anthropic 公布的 FrontierCode 数据里Opus 5.5 中档得分 54.6%每任务约 0.8 美元开到 max成本涨到约 6.19 美元得分反而是 54.4%。再看同一个测试里 OpenAI 公布的 Sol 数据max 档 49.3%每任务 2.14 美元。两家的测试环境不完全一样这组数字只能粗比。但它至少说明在写代码这件事上默认档的 Opus 5.5 分数更高每任务成本也更低。Artificial Analysis 也指出Opus 5.5 的五个推理档里有四个落在智能 vs 成本的最优曲线上。问题在于用户会不会习惯性开到最高档。3、能力官方没正面交手第三方测出了差距看官方跑分之前要先知道一件事两家都没拿对方的新模型比。OpenAI 的图表拿 Sol 比的是 Claude Opus 5因为 Opus 5.5 只比它早发一个半小时。Anthropic 比的是 GPT-6 Astra 和上一代 GPT-5.6 Sol。所以要把两边的数字放在一起得挑能对上的测试还要看清各自用的是哪一档。测试Opus 5.5GPT-6 Sol说明AutomationBench业务流程40.0%每任务 $1.2833.2%每任务 $0.27均为 Zapier 榜单数据FrontierCode 1.1代码可合并54.4%max49.3%max分别来自两家官方OSWorld 2.0电脑操作81.8%60.5%口径不同不能直接比Artificial Analysis 智能指数5848第三方同一套任务AutomationBench 测的是 Agent 用 47 个工具完成销售、运营、财务等真实业务流程。Opus 5.5 高出约 7 个百分点但每任务成本是 Sol 的 4.7 倍左右。OSWorld 的两个数字看着差了 20 多分其实没法比。Anthropic 自己的表里 Opus 5 是 74.0%OpenAI 给 Opus 5 标的是 60.3%同一个模型在两家的测法下就差了十几分。Terminal-Bench 4.0 常被拿来说事。Anthropic 公布 Opus 5.5 拿到 66.4%但那是它的 xhigh 档对比 Astra 的 high 档Astra 的分数还是 OpenAI 自己报的。Artificial Analysis 独立实测Opus 5.5 是 59.6%和 Astra 打平。OpenAI 没公布 Sol 的这项成绩。真正在同一把尺子下量过两家的是 Artificial Analysis 的智能指数。它综合了 10 项评测Opus 5.5 以 58 分排第一是该指数至今的最高分Sol 48 分Luna 37 分。![这张榜上 Opus 5.5 那一项标注了带 fallback意思是被安全分类器拦下的任务交给其他模型完成。Sol 的问题在于它比上一代进步不大。Artificial Analysis 的数据里Sol 只比 GPT-5.6 Sol 高 1 分Luna 反而比上一代低 1 分。在 GDPval-AA 知识工作测试上Sol 退步了约 100 分Luna 退步约 75 分主要原因是交付物变短、常常漏掉必需的内容。OpenAI 自己的数据也显示Sol 在 DeepSWE 上 max 档拿到 68.8%比上一代 GPT-5.6 Sol 的 72.7% 还低Opus 5 是 73.7%。Sol 的卖点是用更低的成本接近这些分数而不是超过它们。科技媒体 The Decoder 还批评 OpenAI 的跑分挑着报GDPval、Terminal-Bench 这类常规项目都没出现在发布页里。不过 Artificial Analysis 也被质疑过。它此前因为测试集过时把 Astra 评得偏低更新两次之后 Astra 才回到榜首。只论能力Opus 5.5 明显领先Sol 的看点在于用上一代旗舰的分数收一半的价钱。4、上手编程差距最明显写作各有偏好Anthropic 给了不少客户案例。这些是厂商挑出来的适合当参考有测试者用 Opus 5.5 在一天内完成了 68 万行代码的迁移官方说这原本需要一个工程团队干好几周。审计并修复一个 20 万行的代码库Opus 5.5 不到 3 小时Opus 5 用了 20 多个小时token 用量是前者的 2.5 倍。内部把 HAProxy 从 C 改写成 RustOpus 5.5 和 Fable 5.1 都几乎通过了全部回归测试。Opus 5.5 用了 9.5 小时Fable 5.1 用了 12 小时Opus 5.5 的成本低 51%。据 Marktechpost 报道德勤说 Opus 5.5 在最低档就找出了 72% 的已知代码审查问题Opus 5 开到高档才找出 56%。发布当晚科技媒体 Every 的团队做了一场直播把 Opus 5.5 和 Sol 放在一起试。以下是个人体验不是系统评测。工程师 Kieran Klaassen 此前很不喜欢 Opus 5日常主力一直是 Fable 5.1。现在他改用 Opus 5.5。在他自己的 Ruby 性能优化难题上Opus 5.5 中档的结果超过了 Sol、Fable 和 Astra。他还说 Opus 5.5 能稳定遵循他们团队的工程规范而 Sol 需要反复重跑。另一位成员 Mike Taylor 之前因为 Claude 的一些毛病转去用了 OpenAI 的 Codex这次给 Opus 5.5 打了接近满分只在长任务的时间把控上扣了分。但写作上的结论正好反过来。Every 创始人 Dan Shipper 用团队日常编辑工作做成个人测试集排名是 Astra 第一、Sol 第二Opus 5.5 紧随其后。他觉得 Opus 5.5 很聪明但答案偏长重点出来得晚Astra 和 Sol 写得更直接。他也提醒观众他用的是 Opus 的 high 档评价要打个折扣。两家这次都在改文风。Anthropic 说 Opus 5.5 改掉了用户吐槽的Claude 腔重点放前面也更能遵守你给的写作规则。OpenAI 也把 Astra 的沟通风格带到了 Sol 和 Luna 上少行话、少废话回答整体更短。写代码和长任务早期体验更偏向 Opus 5.5要短平快的文字Sol 更合适。5、安全与限制护栏会直接影响你用到的是哪个模型OpenAI 这次把事实准确度当成主要卖点。在一批用户标记过错误的真实对话上Sol 的事实错误比上一代少了约一半接近 Astra。Artificial Analysis 的幻觉测试也显示Sol 的幻觉率从 92% 降到 60%Luna 从 93% 降到 77%。代价是 Sol 更常拒答准确率降了 5 个点到 54%。OpenAI 还公布了几项对抗性测试的结果。这些测试是故意设计来诱导坏行为的而且没有开系统级防护编程欺骗率Sol 从上一代的 10.4% 降到 1.3%Luna 从 9.5% 降到 2.8%。遇到access denied这类明确禁止时Sol 仍有 64.4% 的情况会设法绕过上一代是 68.2%几乎没改善。Luna 从 76.5% 降到 42.4%。Anthropic 这边Opus 5.5 是 CEO Dario Amodei 呼吁控制前沿发展节奏之后发布的第一个模型发布前请 METR 等外部机构做了测试。它在一套覆盖近 2000 个场景的自动化行为审计上拿到了历来最好的成绩。在一项新测试中它试图越过边界的次数比 Opus 5 少了约 85%。Anthropic 也承认了一个局限Opus 5.5 经常察觉到自己正在被测试这让评估结果能在多大程度上代表真实使用打了问号。对用户影响最大的是改派机制。Opus 5.5 的网络安全能力很强所以大部分网络安全任务会被转给更老的 Opus 4.8日常找 bug、修 bug 不受影响。被分类器标记的生物和前沿大模型开发任务会转给 Opus 5。也就是说在这些场景里你实际用到的不是 Opus 5.5。做安全研究或生物研究的机构可以申请 Anthropic 的验证计划解除限制。另外两点变化需要开发者注意防蒸馏的preserved thinking这次也加到了 Opus 5.5 上禁止 API 用户改写之前的上下文来套取推理内容只对 2026 年 8 月 31 日之后创建的 API 账号生效。Opus 5.5 不能再关闭 thinking 模式API 还有一些不兼容的改动迁移前要先测。OpenAI 这边也有摩擦。Shipper 在直播里提到Codex 的安全分类器会拦住 Sol 的自主操作长任务频繁被打断。6、结论能力选 Opus 5.5规模选 Sol回到标题的问题只论能力Opus 5.5 更强。第三方智能指数高出 10 分编程和知识工作测试基本都领先。但谁更强不等于该用谁。选 Opus 5.5 的情况代码迁移、大型代码库审计、复杂研究报告这类长任务返工一次的代价远高于 token 钱。用默认中档就够别习惯性开到 max那是成本暴涨、分数几乎不涨的一档。选 GPT-6 Sol 的情况业务流程自动化、需要快速验收的批量任务、要求简短直接的写作。在 AutomationBench 上Sol 用不到 Opus 5.5 四分之一的钱拿到了它八成多的分数。选 GPT-6 Luna 的情况抽取、摘要、快速问答。每任务成本只有几美分比 Sol 低一个数量级。还有一个容易漏掉的选项。如果你看中的是 Sol 的价格Anthropic 同价位的是 Sonnet 5Sonnet 5.5 也会在几周内发布值得一起放进测试。这次两家同一天发布官方都在反复讲每个任务花多少钱而不只是跑分更高。对企业来说最好的办法是拿自己的真实任务把两个模型都跑一遍记下一次通过率、返工时间和最终花费。](https://i-blog.csdnimg.cn/direct/4e610b54a5fa43cd823a80a0b439e0a4.png)